
Das Format
Markdown + YAML. Funktioniert in jedem Editor, der Text öffnet. Keine neuen Tools erforderlich, um mit dem Schreiben zu beginnen.
SpecScore ist ein offenes, lintbares Dateiformat für Spezifikationen, geschrieben in Markdown und YAML (YAML Ain't Markup Language) – wie JSON (JavaScript Object Notation) für Daten – mit einer Befehlszeilenschnittstelle (CLI), die deine Agenten aufrufen, um sie abzufragen und zu bearbeiten, wie jq für JSON.
Erst eine Rückfrage mitten im Build. Dann ein Fix nach dem Release. Dann der Kontext, den du immer wieder neu erklären musst.
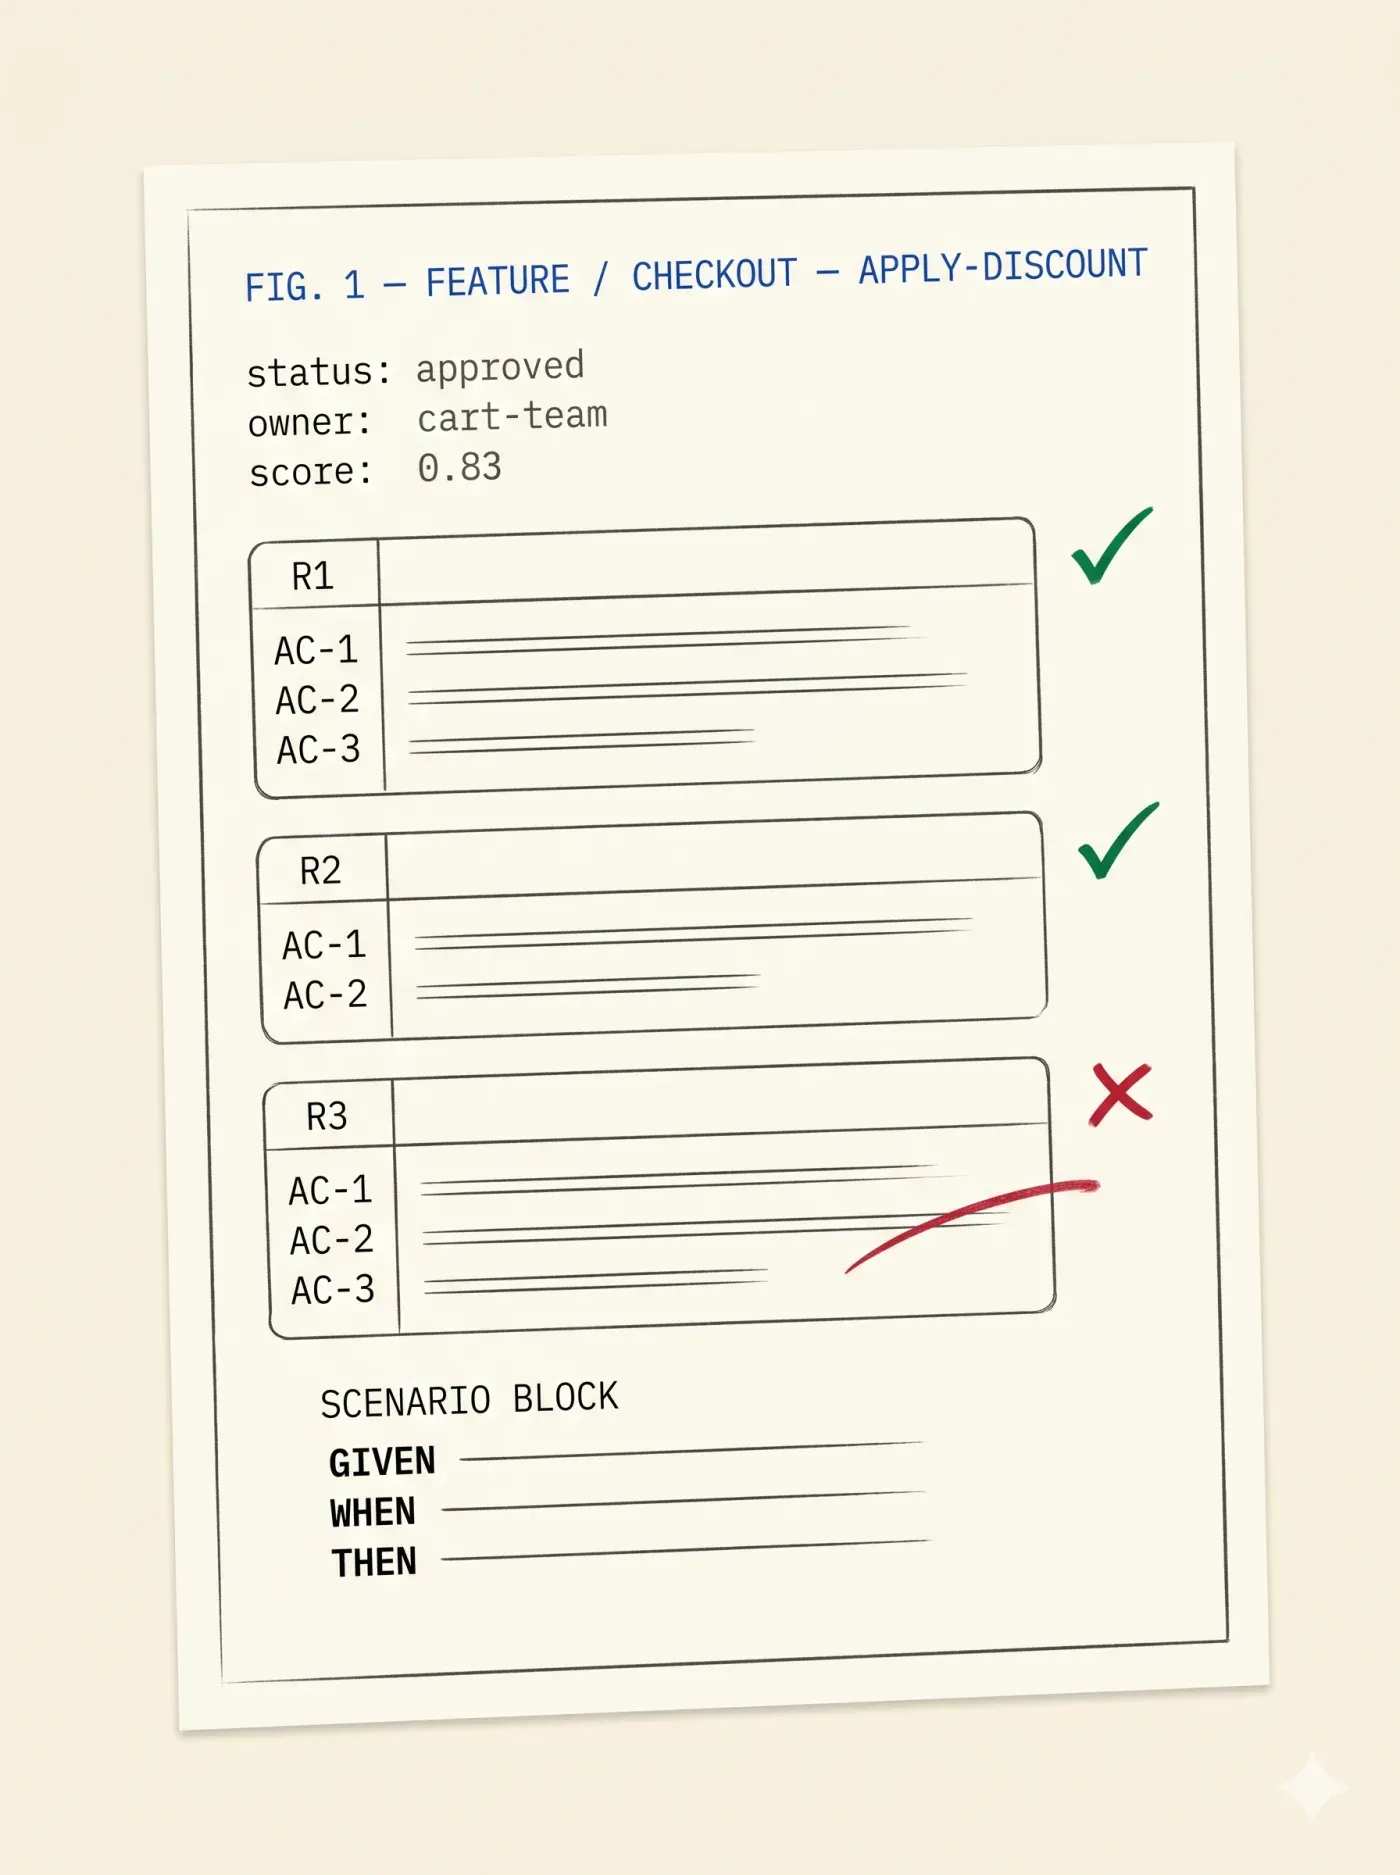
SpecScore ist ein Markdown + YAML-Format für Features, Anforderungen und Akzeptanzkriterien. Es definiert eine Struktur, die dein Team und deine KI-Agenten gleichermaßen verstehen – und es sind einfach Dateien in deinem Repository.
Ein SpecScore-Projekt besteht aus drei Arten von Artefakten entlang eines Lebenszyklus: Eine Idea erfasst eine grobe Richtung; eine Feature-Spezifikation friert das vereinbarte Verhalten ein; ein Planzerlegt das Feature in geordnete Aufgaben, von denen jede die Akzeptanzkriterien nennt, die sie erfüllt.
Warum es für deinen Agenten wichtig ist. Weil die Struktur maschinenlesbar ist, können KI-Agenten die Spezifikation über die CLI abfragen, anstatt jede Datei einzulesen. Frage „Woran sollte ich als Nächstes arbeiten?“und die CLI liefert offene Features und ungeklärte Fragen. Die gleiche Form, die dein Team prüft; deutlich weniger Kontext, den der Agent laden muss.
Eine flache Liste mit fünfzig Features verkommt zur Müllhalde. SpecScore hält den Baum navigierbar: Eltern definieren den Umfang, Kinder die Details, und die Verzeichnisstruktur spiegelt die Produktarchitektur wider, über die dein Team ohnehin nachdenkt.
Offene Fragen steigen nach oben. Unbeantwortete Fragen auf jeder Tiefe erscheinen im Index jedes übergeordneten Elements. Du siehst direkt an der Spitze des Baums, was ein Release blockiert, ohne graben zu müssen.
Die meisten Spezifikationswerkzeuge gehen davon aus, dass eine flache Liste ausreicht. Und das tut sie auch – bis sie es nicht mehr tut. SpecScore ist für den Moment gebaut, in dem die Frage „Wo gehört dieses Feature hin?“ entscheidend wird.
specscore-cli/spec/features/cli/spec/features/cli/
├── agent/
│ └── setup/
├── feature/
│ ├── change-status/
│ ├── deps/
│ ├── info/
│ ├── list/
│ ├── new/
│ ├── refs/
│ └── tree/
├── idea/
│ ├── change-status/
│ ├── new/
│ └── relocate/
├── spec/
│ └── lint/
│ ├── issue-rules/ ← Sub-Sub-Feature
│ └── plan-rules/
├── task/
│ ├── info/
│ ├── list/
│ └── new/
└── … 10 weitere Features der obersten EbeneDie Spezifikation im Dokument, der Thread in Slack und der Code im PR weichen wochenlang stillschweigend voneinander ab. Niemand weiß, welche Version des Gesprächs kanonisch ist.
Die Lösung
Eine einzige kanonische Spezifikation im Repository, versioniert zusammen mit dem Code. specscore lint läuft in der CI bei jedem Push; die Git-Historie ist der Prüfpfad. Spezifikation, Thread und PR können nicht unbemerkt voneinander abweichen – sie teilen sich dieselbe geprüfte Datei.
„Fehler elegant behandeln“ sollte eigentlich heißen:„Toast anzeigen und zurückrollen.“ Oder war es„loggen und wiederholen“? Der Agent muss raten.
Die Lösung
Der Linter fängt mehrdeutige Kriterien ab, bevor auch nur eine Zeile Code geschrieben wird. Das Verb fällt durch das Linting, weil ihm ein konkretes Objekt oder eine Bedingung fehlt. Die Warnung zu beheben zwingt dich aufzuschreiben, was „behandeln“tatsächlich bedeutet.
Menschen interpolieren, fragen nach, klären auf. KI-Agenten nicht – sie implementieren das Muster, das in ihren Trainingsdaten am häufigsten vorkam. Der Code besteht das Review, weil er irgendetwas Sinnvolles tut. Nur eben nicht das, was du meintest.
Die Lösung
Strukturierte Eingabe. KI-Agenten parsen REQ-IDs, AC-IDs und GIVEN / WHEN / THEN-Szenarien deterministisch – es gibt nichts zu interpolieren. Jeder Plan muss die AC-IDs nennen, die jede Aufgabe erfüllt, sodass das Gebaute immer gegen das Spezifizierte überprüfbar bleibt.
Der Agent baut etwas anhand eines mehrdeutigen Briefings, du bemerkst den Fehler und promptest ihn erneut – auf vier verschiedene Arten. Jedes halbfertige Feature und jeder Neuversuch kostet Tokens. Je vager die Spezifikation, desto mehr Runden vergehen bis zum Ziel.
Die Lösung
Linte die Spezifikation, bevor der Agent startet.specscore lint weist vage Verben und fehlende Akzeptanzkriterien von vornherein ab, sodass der Agent ein konkretes Briefing einmal umsetzt, anstatt über mehrere Schleifen hinweg zu raten. Der günstigste Agenten-Durchlauf ist der, den du nicht wiederholen musst.
Ein KI-Agent, der beantworten soll: „Was hängt von diesem Feature ab?“, liest das gesamte README des Features. Dann jeden übergeordneten Index. Dann geschwisterliche Features zur Sicherheit. Jede Abfrage ist ein neuer Parsing-Vorgang. Tokens verpuffen; die Latenz steigt; und die Rechnung steigt mit.
Die Lösung
Strukturierte Abfragen statt Datei-Lesen.specscore feature tree liefert die Hierarchie als YAML; feature deps durchläuft die transitive Abhängigkeitskette; feature info liefert Status, Owner und offene Fragen – jeweils in einem einzigen Aufruf. Der Agent navigiert den Graphen, nicht die Prosa.
Sechs Monate später debuggst du eine Funktion und niemand erinnert sich mehr, welches Feature sie implementiert. Die Verknüpfung zwischen Code und Spezifikation lebte in jemandes Kopf – und diese Person ist längst weg. Der PR, der sie einführte, liegt tief im Archiv.
Die Lösung
Quellcode-Annotationen. Kommentare wie// specscore: features/checkout/apply-discount/R1.AC-2machen die Verknüpfung maschinenlesbar und überstehen jedes Refactoring. specscore code deps beantwortet„Welche Spezifikation implementiert diese Datei?“ in einem einzigen Aufruf; der Linter markiert Referenzen auf gelöschte Spezifikationen.
Du änderst ein Feature in seinem README von Draftauf Approved, aber der übergeordnete features-index führt es weiterhin als Draft. Drei Wochen später liest ein Agent den Index und glaubt, es sei noch im Review. Der Status lebt an zwei Stellen – und sie widersprechen sich.
Die Lösung
specscore feature change-status schreibt das Status-Feld des Features um und synchronisiert die Zeile im features-index in einem atomaren Schritt neu – schlägt der Lint fehl, wird die Änderung rückgängig gemacht. Der Status existiert an einem einzigen kanonischen Ort; der Index ist eine daraus generierte Ansicht.
Eine Spezifikation liest sich, als sei alles geklärt – bis dir einfällt, dass die Frage „Und was ist mit Zeitzonen?“vor zwei Monaten in einem Slack-Thread unterging und nie im Dokument landete. Jetzt bist du mitten in der Implementierung und niemand kennt die Antwort.
Die Lösung
Jedes SpecScore-Feature hat einen PflichtabschnittOutstanding Questions. Der Linter lehnt Features ab, die ihn auslassen – leer ist in Ordnung ("None at this time."), aber fehlend nicht. Ungelöste Fragen stehen sichtbar im Dokument, sind per CLI abfragbar und können nicht vergessen werden.
SpecStudio Skillsist ein Claude Code Plugin, das den SpecScore-Lebenszyklus in vier Slash-Befehle verwandelt. Einmal installieren, danach der Reihe nach ausführen – von der rohen Idee bis zum ausführbaren Plan.
$ /plugin marketplace add specscore/ai-marketplace
$ /plugin install specstudio@specscore
> /specstudio:
   /specstudio:ideate     Eine rohe Idee in eine SpecScore Idea verfeinern
   /specstudio:specify    Eine freigegebene Idea in eine Feature-Spezifikation umwandeln
   /specstudio:plan       Ein Feature in einen Aufgabenplan zerlegen
   /specstudio:implement  Die nächste Aufgabe des Plans ausführen
Kostenlos für jede Nutzung, auch kommerziell. Der Quellcode des Plugins liegt aufspecscore/specstudio-skills – unter MIT-Lizenz.
Ein schneller, deterministischer Linter gefolgt von einem tieferen KI-Review – ausgeführt auf der Spezifikation, die du gerade gesehen hast. Zwei Durchgänge, zwei Arten von Gewissheit.
$ specscore spec lint

features/apply-discount/README.md:0 [error] oq-section: Open Questions section not found
features/apply-discount/README.md:0 [error] index-entries: Child directory not listed in index: refunds
features/apply-discount/refunds:0 [error] readme-exists: README.md not found

3 violations found (3 errors)
# exit code 1
Das gleiche Ergebnis bei jedem Lauf. Kostenlos, blitzschnell, läuft bei jedem Commit.
> /score apply-discount.md

  Grade: B  — ready with edits
  AC-2  vague trigger — name the actor and event
  AC-3  no error path for an expired code
  prose reads clean; criteria need tightening
Liest nach Sinn und Logik, genau wie ein menschlicher Reviewer.
Markdown + YAML. Funktioniert in jedem Editor, der Text öffnet. Keine neuen Tools erforderlich, um mit dem Schreiben zu beginnen.
Go-CLI. Validiert Struktur, Referenzen und Integrität. Beendet sich mit Exit-Code ungleich null bei Fehlern – funktioniert in deinem Terminal und in deiner CI.
SpecScore besteht nur aus Dateien in deinem Repository. Kein SaaS-Abo, kein Pflicht-Orchestrator. Nutze es mit Linear, Jira, GitHub Projects, reinem Markdown in einem Ordner oder ganz ohne Projektmanagement-Tool. Dem Format und dem Linter ist es egal, wo deine Tickets liegen.
Spezifikationsgetriebene Entwicklung ist ein belebtes Feld. Hier steht SpecScore im Vergleich zu den Alternativen – ganz ehrlich.
Keine KI-Agenten im Einsatz, oder du brauchst Spezifikationsprüfung in deiner CI-Pipeline? Dafür gibt es eine CLI. Installiert in 60 Sekunden – kein Account, keine Telemetrie, funktioniert in jedem Markdown-Spezifikationsordner.
$ curl -fsSL https://specscore.md/install/get-cli | sh> irm https://specscore.md/install/get-cli.ps1 | iexPrüfe die Beispielspezifikation, die mit der Binärdatei ausgeliefert wird:
$ specscore lint examples/checkout/apply-discount.mdSieh dir die Ausgabe an:
  examples/checkout/apply-discount.md
    ✓ R1  has acceptance criteria
    ✓ R2  has acceptance criteria
    ✗ R3  no acceptance criteria
    ✗ link     "Related Feature: discount-tiers" not found
    ✗ section  "Open Questions" missing

3 problems exit 1Datenbankschemata erkunden, Abfragen erstellen und ausführen sowie Ergebnisse verstehen mit DataTug. SpecScore steuert die Anforderungen und Akzeptanzkriterien.
datatug.app Die Tools dahinterOffene Registry für Datenmodelle und semantische Definitionen – in eigenen Git-Repositories gepflegt und mit Modellen und Code verknüpft.
meaninggraph.io Registry durchsuchenCode-Graph-Engine für schnelle Code-Exploration und bidirektionale Verknüpfung zwischen Spezifikation und Code.
codegrapher.devGo-Datenzugriffsschicht, spezifiziert mit SpecScore.
dal-go.github.ioGit-gestützte versionierte Datenbank, spezifiziert mit SpecScore.
ingitdb.comAkzeptanz-Nachweisschicht – führt die Akzeptanzkriterien einer Spezifikation tatsächlich aus, mit wiederverwendbaren Prüfungen und ohne Glue-Code.
rehearse.inkWeb-Oberfläche zum Anzeigen und Bearbeiten von SpecScore-Spezifikationen.
specscore.studioSpecScore legt fest, wann dein Projekt fertig ist. Ein Wochenziel hilft dir, den nächsten Schritt zu wählen. Verbinde beides mit einer kurzen Prüfung der Ergebnisse.
★ Gib uns einen Stern auf GitHub — hilft anderen, das Projekt zu finden.
Have an idea how to improve this page?