
포맷
Markdown + YAML. 텍스트를 열 수 있는 모든 편집기에서 작동합니다. 작성을 시작하는 데 새로운 도구가 필요하지 않습니다.
그다음은 구현 중의 확인 질문. 그다음은 출시 후의 수정. 그다음은 몇 번이고 다시 설명하는 맥락.
SpecScore는 명세를 위한 린트 가능한 오픈 파일 포맷입니다 — 데이터에 대한 JSON처럼. 에이전트가 질의·편집을 위해 호출하는 CLI와 함께 — JSON에 대한 jq처럼.
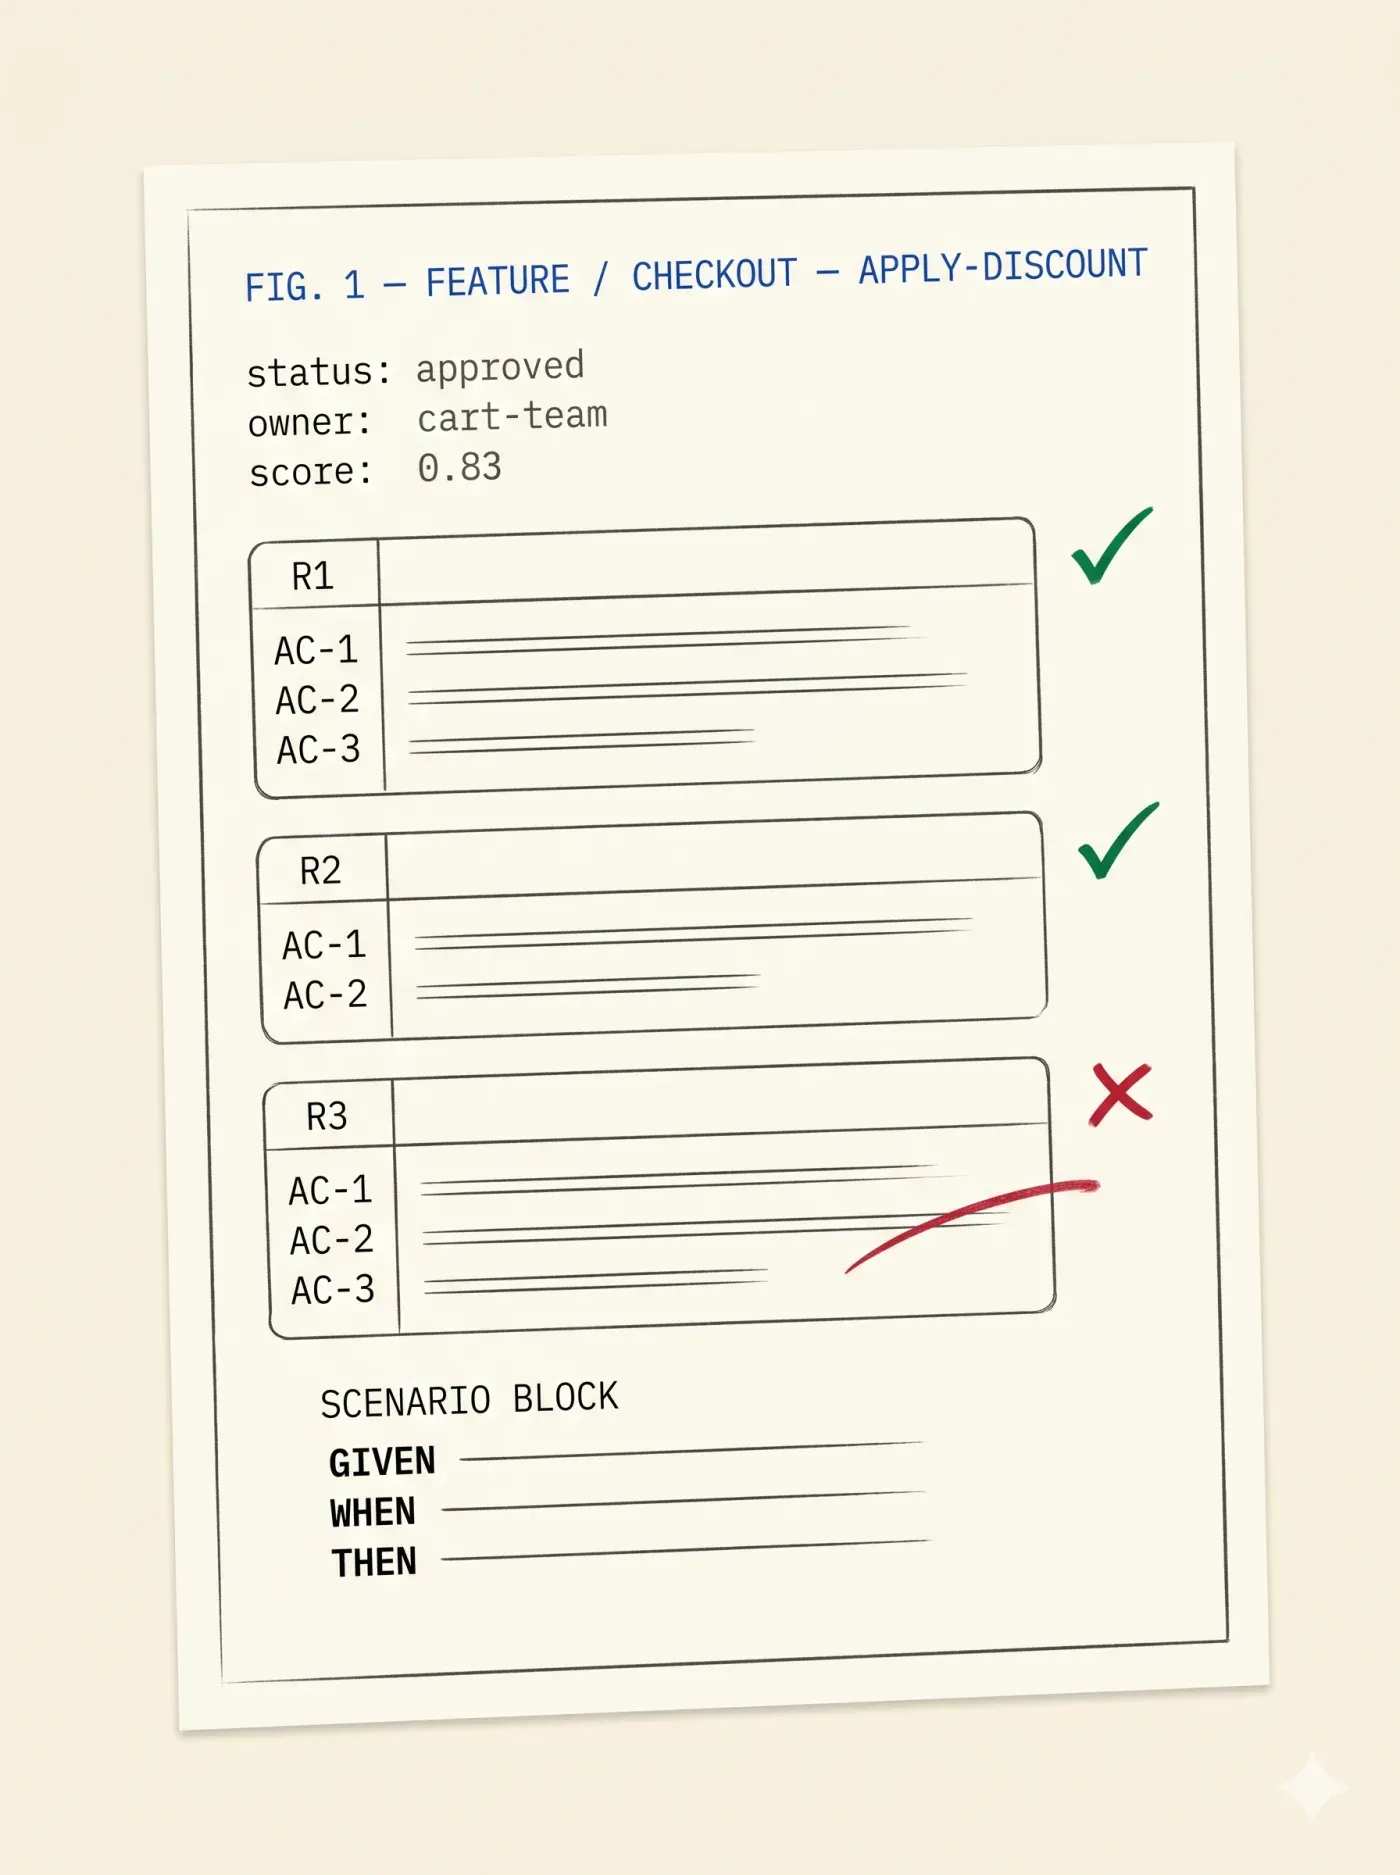
SpecScore는 Markdown + YAML 포맷으로 기능, 요구사항, 인수 기준을 정의합니다. 팀과 AI 에이전트 모두 이해할 수 있는 구조를 제공하며, 저장소에 있는 파일 그대로입니다.
SpecScore 프로젝트는 라이프사이클을 따르는 세 가지 아티팩트로 구성됩니다: 아이디어는 반쯤 형성된 방향을 포착하고,기능 명세는 합의된 동작을 확정하며,계획은 기능을 충족시킬 인수 기준을 각각 인용하는 순서화된 작업으로 분해합니다.
왜 에이전트에 중요한가. 구조가 기계 판독 가능하므로, AI 에이전트는 모든 파일을 읽는 대신 CLI를 통해 명세에 질의할 수 있습니다. “다음에 무엇을 작업해야 하나요?”라고 물으면 CLI가 열려 있는 기능과 답이 안 된 질문을 돌려줍니다. 팀이 검토하는 것과 같은 형태이지만, 에이전트가 불러와야 하는 컨텍스트는 훨씬 적습니다.
기능이 50개가 되면 평면 리스트는 쓰레기 더미가 됩니다. SpecScore는 트리를 탐색 가능하게 유지합니다 — 부모는 범위를, 자식은 세부 사항을 가지며, 디렉터리 구조는 팀이 이미 머릿속에서 다루고 있는 제품의 구조를 그대로 비춥니다.
열린 질문은 위로 올라옵니다.어느 깊이에 있든 해결되지 않은 질문은 모든 상위 인덱스에 드러납니다. 릴리스를 막고 있는 것이 무엇인지, 깊이 파고들지 않고도 트리 꼭대기에서 볼 수 있습니다.
대부분의 명세 도구는 평면 리스트면 충분하다고 가정합니다. 어느 순간까지는 충분합니다 — 그러다 아니게 됩니다. SpecScore는 “이 기능은 어디에 살아야 하지?”가 중요해지는 바로 그 순간을 위해 만들어졌습니다.
specscore-cli/spec/features/cli/spec/features/cli/
├── agent/
│ └── setup/
├── feature/
│ ├── change-status/
│ ├── deps/
│ ├── info/
│ ├── list/
│ ├── new/
│ ├── refs/
│ └── tree/
├── idea/
│ ├── change-status/
│ ├── new/
│ └── relocate/
├── spec/
│ └── lint/
│ ├── issue-rules/ ← 서브-서브 기능
│ └── plan-rules/
├── task/
│ ├── info/
│ ├── list/
│ └── new/
└── … 최상위 기능 10개 더문서의 명세, Slack의 스레드, PR의 코드가 몇 주 동안 조용히 서로 어긋납니다. 어떤 버전의 대화가 정본인지 아무도 찾을 수 없습니다.
해결책
저장소에 하나의 정본 명세를 두고 코드와 함께 버전 관리합니다.specscore lint가 매 push마다 CI에서 실행되고, git 이력이 감사 추적 역할을 합니다. 명세, 스레드, PR이 조용히 어긋날 수 없습니다 — 같은 파일을 리뷰하니까요.
"오류를 우아하게 처리"가 "토스트를 표시하고 롤백"을 의미하는 건가요? 아니면 "로그 남기고 재시도?" 에이전트는 추측할 수밖에 없습니다.
해결책
린터가 코드 작성 전에 모호한 기준을 잡아냅니다. 구체적인 대상이나 조건이 없는 동사는 린트를 통과하지 못합니다. 경고를 해결하려면 "처리"가 실제로 무엇을 의미하는지 명시해야 합니다.
사람은 추론하고, 질문하고, 명확히 합니다. AI 에이전트는 그렇지 않습니다 — 학습 데이터에서 가장 흔한 패턴을 구현합니다. 코드가 리뷰를 통과하는 이유는 뭔가 합리적인 것을 하기 때문입니다. 다만 의도한 것이 아닐 뿐입니다.
해결책
구조화된 입력. AI 에이전트는 REQ ID, AC ID 및GIVEN / WHEN / THEN시나리오를 결정론적으로 파싱합니다 — 추론할 것이 없습니다. 계획의 각 작업은 충족시키는 AC ID를 인용해야 하므로, 구현된 내용을 항상 명세와 대조 확인할 수 있습니다.
에이전트가 모호한 지시를 바탕으로 무언가를 만들고, 당신은 그게 잘못됐다는 걸 알아채고, 네 가지 방식으로 다시 지시합니다. 절반만 만들어진 기능도, 매번의 재시도도 모두 토큰으로 청구됩니다. 명세가 모호할수록 완성까지의 왕복이 늘어납니다.
해결책
에이전트가 실행되기 전에 명세를 린트하세요.specscore lint가 모호한 동사와 누락된 인수 조건을 처음부터 걸러내므로, 에이전트는 재시도를 거치며 추측하는 대신 구체적인 지시를 한 번에 구현합니다. 가장 저렴한 실행은 다시 반복하지 않는 실행입니다.
"이 기능에 의존하는 것이 무엇인가?"에 답하는 AI 에이전트는 기능 README 전체를 읽습니다. 그다음 모든 상위 인덱스를 읽습니다. 그다음 혹시나 해서 형제 기능까지. 매번 쿼리가 새로운 파싱입니다. 토큰은 증발하고, 지연은 증가하며, 비용도 함께 올라갑니다.
해결책
파일 읽기 대신 구조화된 쿼리.specscore feature tree는 계층구조를 YAML로 반환하고, feature deps는 전이적 의존성 체인을 탐색하며, feature info는 상태, 소유자, 미해결 질문을 노출합니다 — 각각 한 번의 호출로. 에이전트는 산문이 아니라 그래프를 탐색합니다.
6개월 후, 어떤 함수를 디버깅하는데 어떤 기능을 구현하는 것인지 아무도 기억하지 못합니다. 코드와 명세 사이의 연결은 누군가의 머릿속에 있었고, 그 사람은 퇴사했습니다. 도입된 PR은 아카이브 속에 있습니다.
해결책
소스 어노테이션.// specscore: features/checkout/apply-discount/R1.AC-2같은 주석이 연결을 기계 판독 가능하게 만들고 모든 리팩터링에서 살아남습니다. specscore code deps는 "이 파일이 어떤 명세를 구현하나?"에 한 번의 호출로 답하고, 린터는 삭제된 명세를 가리키는 참조를 표시합니다.
기능을 README에서 Draft에서 Approved로 변경했지만, 상위 features-index에는 여전히 Draft로 나옵니다. 3주 후, 인덱스를 읽는 에이전트는 아직 작업 중이라고 생각합니다. 상태가 두 곳에 존재하고, 서로 일치하지 않습니다.
해결책
specscore feature change-status가 기능의 Status 필드를 다시 작성하고 features-index 행을 하나의 원자적 단계로 재동기화합니다 — 린트 실패 시 변경을 롤백합니다. 상태는 하나의 정본 위치에 존재하고, 인덱스는 그것의 생성된 뷰입니다.
명세가 확정된 것처럼 읽히지만, 2개월 전 Slack 스레드에서 나온 "타임존은 어떻게 하나요?"라는 질문이 문서에 반영되지 않은 것을 기억합니다. 이제 구현 중인데, 답이 무엇이었는지 아무도 말할 수 없습니다.
해결책
모든 SpecScore 기능에는 필수Outstanding Questions 섹션이 있습니다. 린터는 이 섹션이 없는 기능을 거부합니다 — 비어 있어도 괜찮지만("None at this time."), 빠져 있으면 안 됩니다. 미해결 질문은 문서에서 보이고, CLI에서 조회 가능하며, 잊을 수 없습니다.
SpecStudio Skills는 SpecScore 라이프사이클을 네 개의 슬래시 명령으로 바꿔주는 Claude Code 플러그인입니다. 한 번 설치한 후 순서대로 실행하세요 — 원시 아이디어에서 실행 가능한 계획까지.
$ /plugin marketplace add specscore/ai-marketplace
$ /plugin install specstudio@specscore
> /specstudio:
   /specstudio:ideate     원시 아이디어를 SpecScore Idea로 정제
   /specstudio:specify    승인된 Idea를 Feature 명세로 전환
   /specstudio:plan       Feature를 작업 Plan으로 분해
   /specstudio:implement  Plan의 다음 작업 실행
공개 및 오픈소스 저장소에 무료입니다. 플러그인 소스는specscore/specstudio-skills에 있으며, MIT 라이선스입니다.
빠른 결정적 린터, 그다음 더 깊은 AI 리뷰 — 방금 본 명세에 그대로 실행합니다. 두 번의 점검, 두 종류의 확신.
$ specscore lint apply-discount.md

  ✓ R1  has acceptance criteria
  ✓ R2  has acceptance criteria
  ✗ R3  no acceptance criteria
  ✗ link     "Related Feature: discount-tiers" not found
  ✗ section  "Open Questions" missing

  3 problems   exit 1
실행할 때마다 같은 결과. 무료이고, 빠르며, 모든 커밋에서 실행됩니다.
> /score apply-discount.md

  Grade: B  — ready with edits
  AC-2  vague trigger — name the actor and event
  AC-3  no error path for an expired code
  prose reads clean; criteria need tightening
사람 리뷰어처럼 의미를 읽어냅니다.
Markdown + YAML. 텍스트를 열 수 있는 모든 편집기에서 작동합니다. 작성을 시작하는 데 새로운 도구가 필요하지 않습니다.
Go CLI. 구조, 참조, 완전성을 검증합니다. 실패 시 0이 아닌 종료 코드를 반환합니다 — 터미널과 CI에서 모두 작동합니다.
SpecScore는 저장소에 있는 파일 그 자체입니다. 가입할 SaaS도 없습니다. 오케스트레이터도 필요 없습니다. Linear, Jira, GitHub Projects, 폴더 안의 순수 Markdown, 또는 프로젝트 관리 도구 없이도 사용할 수 있습니다. 포맷과 린터는 티켓이 어디에 있는지 신경 쓰지 않습니다.
스펙 기반 개발은 경쟁이 치열한 분야입니다. SpecScore가 대안들과 비교해 어디에 서 있는지 — 솔직하게 보여드립니다.
AI 에이전트를 사용하지 않거나 CI 파이프라인에서 명세 검증이 필요하신가요? CLI가 있습니다. 60초 만에 설치 — 계정 불필요, 텔레메트리 없음, Markdown 명세가 있는 모든 디렉토리에서 작동합니다.
$ curl -fsSL https://specscore.md/install/get-cli | sh> irm https://specscore.md/install/get-cli.ps1 | iex바이너리에 포함된 예시 명세에 린터를 실행해 보세요:
$ specscore lint examples/checkout/apply-discount.md출력 결과:
  examples/checkout/apply-discount.md
    ✓ R1  has acceptance criteria
    ✓ R2  has acceptance criteria
    ✗ R3  no acceptance criteria
    ✗ link     "Related Feature: discount-tiers" not found
    ✗ section  "Open Questions" missing

3 problems exit 1빠른 코드 탐색과 명세↔코드 양방향 연결을 위한 코드 그래프 엔진.
codegrapher.devSpecScore로 명세된 Go 데이터 액세스 레이어.
dal-go.github.ioSpecScore로 명세된 Git 기반 버전 관리 데이터베이스.
ingitdb.com인수 증거 레이어 — 명세의 인수 기준을 실제로 실행하며, 재사용 가능한 검사로 글루 코드가 필요 없습니다.
rehearse.inkSpecScore 명세를 조회하고 편집하는 웹 UI.
specscore.studio번역 오류를 발견했거나 이 페이지를 개선할 아이디어가 있나요? 알려주세요.